


Page 88 - 《中国图书馆学报》2025年第1期
P. 88
086                  Journal of Library Science in China


           非结构化的特点,识别任务较复杂,传统基于词典和规则的方法难以解决本研究的问题。 机器学习是
           目前最主流、最常用,且在多个领域的命名实体抽取任务中得到有效验证的方法。 该方法又可分为两
           种思路:一种是基于文本的统计分布特征,通过术语的上下词语共现特征完成术语的识别;另一种是
           通过深度神经网络开展基于词语级或字符级的术语领域语义特征学习来完成抽取                                       [16] 。 后者在泛化
           能力和减少依赖人工特征选择方面有着明显优势,同时在没有重叠实体、非连续实体等特殊复杂的情
           况下,最简单最常见的方式就是序列标注方法。 Huang 等提出将 BiLSTM 与 CRF 联合使用来提取上

           下文特征,同时通过 CRF 模型来利用句子级别的标签信息,该模型具有良好的序列建模能力                                       [17] 。
               语言预训练模型表现出强大的文本表示和理解能力,能够很好地为下游任务提供优质的预训练
           输入,将其与 BiLSTM 模型相结合作为底层文本特征编码器嵌入层是目前较为主流且效果尚佳的做
           法,在标签预测环节接入 CRF 层又能达到对准确率的多重保障。 常用的预训练模型有 BERT 与
           RoBERTa。 RoBERTa 模型是对 BERT 进行优化后的语义表征模型,它在集成 BERT 模型优势的同时
           进一步进行了优化        [18] 。

               目前多个领域都有学者将 BiLSTM-CRF 组合模型与预训练模型相结合来完成命名实体识别任
           务。 以 BERT 为基础结合 BiLSTM-CRF 模型,在电子健康档案(EHR)命名实体识别                           [19]  、中文命名实
           体识别   [20]  、中医医案命名实体识别        [21]  及科技文献概念短语抽取         [22] 中表现突出。 以 RoBERTa 为基础
           结合 BiLSTM 与 CRF,在糖尿病在线健康社区实体识别                  [23] 、中文地址解析     [24] 、中文病案实体识别       [25]  、
           英文电子案例实体识别           [26] 中都取得了较好的实验结果。 实践证明,这两种预训练模型与 BiLSTM-
           CRF 的结合能够比单独使用预训练模型取得更优效果,但在本研究的应用场景中,哪种预训练模型

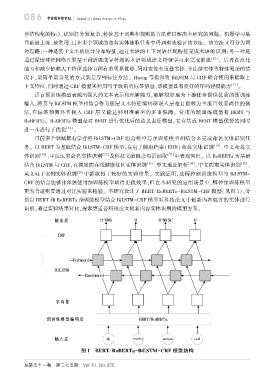
           更为合适则要通过对比实验来检验。 本研究设计了 BERT/ RoBERTa-BiLSTM-CRF 模型(见图 1),分
           别以 BERT 和 RoBERTa 预训练模型结合 BiLSTM-CRF 模型对科技论文中创新内容包含的实体进行
           识别,通过实验结果对比,探索更适合科技论文创新内容实体识别的模型方案。


                                 图 1  BERT/ RoBERTa-BiLSTM-CRF 模型结构


           总第五十一卷  第二七五期  Vol. 51. No. 275

