


Page 93 - 《中国图书馆学报》2025年第1期
P. 93
091
                    曹树金  闫  颂  李睿婧  曹茹烨:科技论文创新知识图谱构建与应用设计———以情报学期刊论文为例


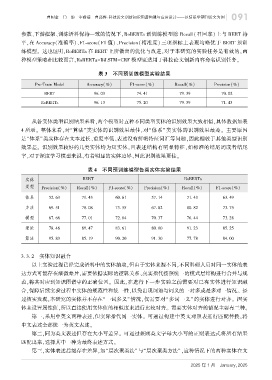
          参数、下游框架、训练语料保持一致的情况下,RoBERTa 预训练模型除 Recall(召回率)上与 BERT 持
          平,在 Accuracy(准确率)、F1-score(F1 值)、Precision(精准度) 三项指标上表现均略优于 BERT 预训
          练模型。 这也证明,RoBERTa 在 BERT 上所做出的优化与改进,对于本研究的实验任务是有效的,两
          种模型策略相比较而言,RoBERTa-BiLSTM-CRF 模型更适用于科技论文创新内容命名识别任务。


                                        表 3  不同预训练模型实验结果

               Pre-Train Model      Accuracy(%)      F1-score(%)       Recall(%)      Precision(%)
                   BERT               96. 03           74. 41           79. 39           70. 02
                 RoBERTa              96. 13           75. 20           79. 39           71. 43


              从各实体类型识别结果来看,两个模型对五种不同类型实体的识别效果大致相似,具体数据如表

         4 所示。 整体来看,对“算法”类实体的识别效果最佳,对“体系” 类实体的识别效果最差。 主要原因
          是“体系”类实体存在文本过长、重复率低、表述没有鲜明特征词汇等问题,因此相较于其他类型识别
          效果差。 识别效果较好的几类实体均为短实体,且表述结构有明显特征,如标准的结尾词或者结尾
          字,对于深度学习模型来说,有着明显的实体边界,因此识别效果更佳。

                                    表 4  不同预训练模型各类实体实验结果

           实体                     BERT                                    RoBERTa
           类型     Precision(%)  Recall(%)   F1-score(%)   Precision(%)    Recall(%)    F1-score(%)
           体系        52. 63       71. 43       60. 61        57. 14        71. 43         63. 49

           方法        69. 51       78. 08       73. 55        67. 82        80. 82         73. 75
           模型        67. 68       77. 01       72. 04        70. 37        76. 44         73. 28

           理论        78. 46       89. 47       83. 61        80. 00        91. 23         85. 25
           算法        95. 83       85. 19       90. 20        91. 30        77. 78         84. 00


         3. 3. 2  实体知识融合
              以上实验过程已经完成语料中的实体抽取,但由于实体来源不同,不同科研人员对同一实体的表
          达方式可能存在细微差异,需要依据实际的逻辑关系、真实指代按照统一的模式层结构进行合并与规
          范,将其对应到知识图谱中的正确位置。 因此,在进行下一步实验之前需要对已有实体进行知识融
          合,保障后续实验过程中实体的规范性和统一性,以免出现词语与词义的一对多或是多对一情况。 经

          过核实发现,本研究的实体并不存在“一词多义”情况,仅需要对“多词一义”的实体进行对齐。 因实
          体未设置属性值,所以直接使用实体值的相似度来进行比较对齐。 需要实体对齐的情况主要有三种。
              第一,采用中英文两种表述,但实际指代同一实体。 可通过构建中英文对照表进行匹配替换,将
          中文表述全部统一为英文表述。
              第二,同为英文表述但存在大小写差异。 可通过兼顾英文字母大小写的正则表达式将所有结果
          匹配出来,选择其中一种为最终表述方式。
              第三,实体表述后缀存在差异,如“层次聚类法”与“层次聚类方法”,这种情况下的两种实体在文


                                                                             2025 年 1 月  January,2025

