


Page 95 - 《中国图书馆学报》2025年第1期
P. 95
093
                    曹树金  闫  颂  李睿婧  曹茹烨:科技论文创新知识图谱构建与应用设计———以情报学期刊论文为例


          为明显的规则可循,且在前期处理工作中,已经将每一个句子根据语义角色及依存句法关系提取出主
          谓宾结构和谓语+宾语结构,形成半结构化数据,用词和结构都具有一定的规律,适合采用基于规则
          的方法来识别。
              以中文情报学期刊论文为例,在所要形成的创新知识网络中,本研究重点关注的“创新基础”关
          系,用来解释说明某一研究创新成果的基础与来源,具体分解到识别任务中,即需要在某一条包含多
          个实体的语料中,识别出哪些实体是最终的创新成果,哪些实体是该研究的基础与参考。 基于以上逻

          辑,在完成创新内容命名实体识别任务、获取每条语料中所有命名实体之后,将“创新基础”这一关系
          的识别过程拆分成对创新基础实体和创新成果实体的分类判断。 然后,将可能存在实体关系的语料
          筛选出来,即包含不少于两个类型实体的语料,人工对语料中各理论、方法等实体间“创新基础”关系
          的表达规则进行总结,采用基于正则表达式和引导词相结合的方式来对实体关系进行提取。 结合引

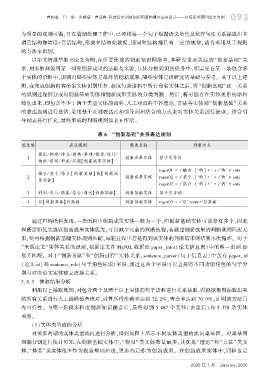
          导词表进行扩充,最终形成的判断规则如表 6 所示。

                                        表 6  “创新基础”关系表达规则
          优先级                表达规则                    筛选目标                     判断方式

                提出/ 构建/ 建立/ 建构/ 搭建/ 探索/ 设计/
            1                                      创新成果实体       基于引导词
                构造/ 得到/ 形成/ 实现【创新成果实体】

                                                                regex01 = r′融合 . [^的]∗′ + r′的′ + enty
                融合/ 基于/ 结合【创新基础】 的【创新成
            2                                      创新成果实体       regex02 = r′基于 . [^的]∗′ + r′的′ + enty
                果实体】
                                                                regex03 = r′结合 . [^的]∗′ + r′的′ + enty
            3   利用/ 引入/ 借鉴/ 结合/ 通过【创新基础】           创新基础实体       基于引导词


            4   以【创新基础】为基础                         创新基础实体       regex03 = r′以′+enty+′为基础′
              通过归纳语料发现,一条语料中创新成果实体一般为一个,但创新基础实体可能存在多个,因此
          判断逻辑优先级以创新成果实体优先,可以减少冗余的判断流程;若通过创新成果的判断规则匹配无
          果,则再根据创新基础实体规则匹配,每轮过程中若是得到该实体的判断结果则结束本次循环。 对于

          “来源论文”实体关系的识别,根据论文在 MySQL 数据库 paper_infor(论文信息表)中的唯一识别 ID
          展开匹配。 对于“创新贡献”和“创新过程” 实体关系,sentence_parser(句子信息表) 中含有 paper_id
          (论文 id)和 sentence_role(句子角色标识)字段,通过这两个字段可以直接将不同功能角色的句子分
          别与对应论文实体建立连接关系。
         3. 4. 3  抽取结果分析
              利用以上抽取规则,对包含两个及两个以上实体的句子语料进行关系抽取,将根据规则抽取出来
          的所有关系进行人工抽样检查核对,计算所得准确率达到 72. 2%,查全率达到 76. 9%,证明该方法具

          有可行性。 与第一阶段多粒度创新知识融合后,最终得到 5 487 个实体(去重后) 和 5 378 条实体


          关系。
              (1)实体类型流向分析
              对关系两端的实体类型流向进行分析,得到如图 3 所示不同实体类型的流向桑基图。 对桑基图
          两端分别进行统计可知,在创新基础实体中,“模型”类实体数量最多,其次是“理论” 和“方法” 类实
          体,“体系”类实体很少作为创新基础出现,更多的是作为创新成果。 在创新成果实体中,同样也是


                                                                             2025 年 1 月  January,2025

