


Page 43 - 《中国图书馆学报》2025年第1期
P. 43
041
                 裘江南  高双燕  黄榕江  李梦洁:AIGC 背景下人智认知导向的信息检索范式———基于世界 3 理论的探究


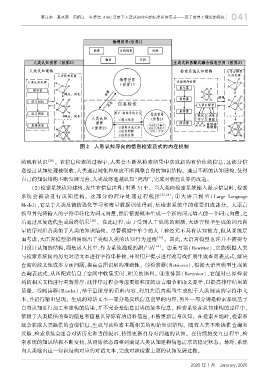
                                 图 2  人智认知导向的信息检索范式的内在机制


          的现有认识     [26]  。 在信息检索的过程中,人类会不断从检索结果中获取新的有价值的信息,这部分信
          息经过认知处理被吸收,人类通过同化和顺应不断调整自身的知识结构。 通过不断的认知建构,使得
          自己的知识结构不断发展完善,人类最终逾越认知“鸿沟”,完成对物理世界的改造。
              (2)检索系统认知建构,发生在信息世界(世界 3)中。 当人类向检索系统输入提示信息时,检索
          系统会被动进行认知建构。 这部分的程序处理过程包括                              [27,28] : ① 大语言模型 ( Large Language

          Model),它基于人类反馈的强化学习和海量数据训练得到,是检索系统中的重要组成部分。 大语言
          模型首先将输入的字符串转化为词元向量,然后依据概率生成一个新的词元填入前一个词元向量,之
          后通过反复迭代生成最终结果              [28]  。 在此过程,由于受到人工训练的刺激,大语言模型生成的词元向
          量的序列组合类似于人类的知识结构。 尽管模型中单个的人工神经元不具有认知能力,但从系统层

          面考虑,大语言模型架构涌现出了类似人类的认知行为过程                            [29]  。 因此,大语言模型也许并不需要专
          门设计认知的结构,而是嵌入其中,作为系统涌现的副产品                          [14] 。 ②重写器(Rewriter),它能根据人类
          与检索系统间的历史对话文本进行字符串拼接,并对用户提示进行改写或扩展生成查询表达式,解决
          查询的歧义性或多方面问题,提高意图识别的准确性。 ③检索器(Retriever),根据大语言模型生成的
          查询表达式,从匹配式信息子空间中收集实时、相关的语料。 ④重排器(Reranker),它能对已经检索

          到的相关文档进行重新排序,此排序过程会考虑更细粒度的语言细节和语义差异,以提高排序结果的
          质量。 ⑤阅读器(Reader),基于重排序的语料内容,利用大语言模型生成便于人类阅读的字符串文

          本,并进行输出呈现。 生成的对话文本一部分是反映信息世界的内容,另外一部分则是检索系统基于
          自身认知进行加工和建构的结果,并不完全是信息世界的原本信息。 检索系统在认知建构的过程中,
          依赖于人类提供的查询信息和信息世界原有的语料信息,不断更新自身认知。 在检索开始时,检索系
          统会获取人类提供的查询信息,生成与该检索主题相关的初始知识结构。 随着人类不断提供查询和
          反馈,检索系统会组合对话历史和当前提示,持续更新自身对问题的认知。 在持续的交互过程中,检
          索系统的知识结构不断变化,从初始状态调整到满足人类认知建构信息需求的稳定状态。 最终,系统

          向人类输出这一知识结构对应的对话文本,完成对该检索主题的认知发展过程。

                                                                             2025 年 1 月  January,2025

